Blog

記事一覧

すべて (93) AI (64) Python (22) LLM (21) Business (17) Infrastructure (16) Machine Learning (14) Investment (12) OpenAI (11)
第1回 話題のAI「Jev」は何がすごいのか? NerveReflexとオープンモデルで再現に成功 連載
AIJevNerveReflexHidden StateGemmavLLMInference CostCalibration

第1回 話題のAI「Jev」は何がすごいのか? NerveReflexとオープンモデルで再現に成功

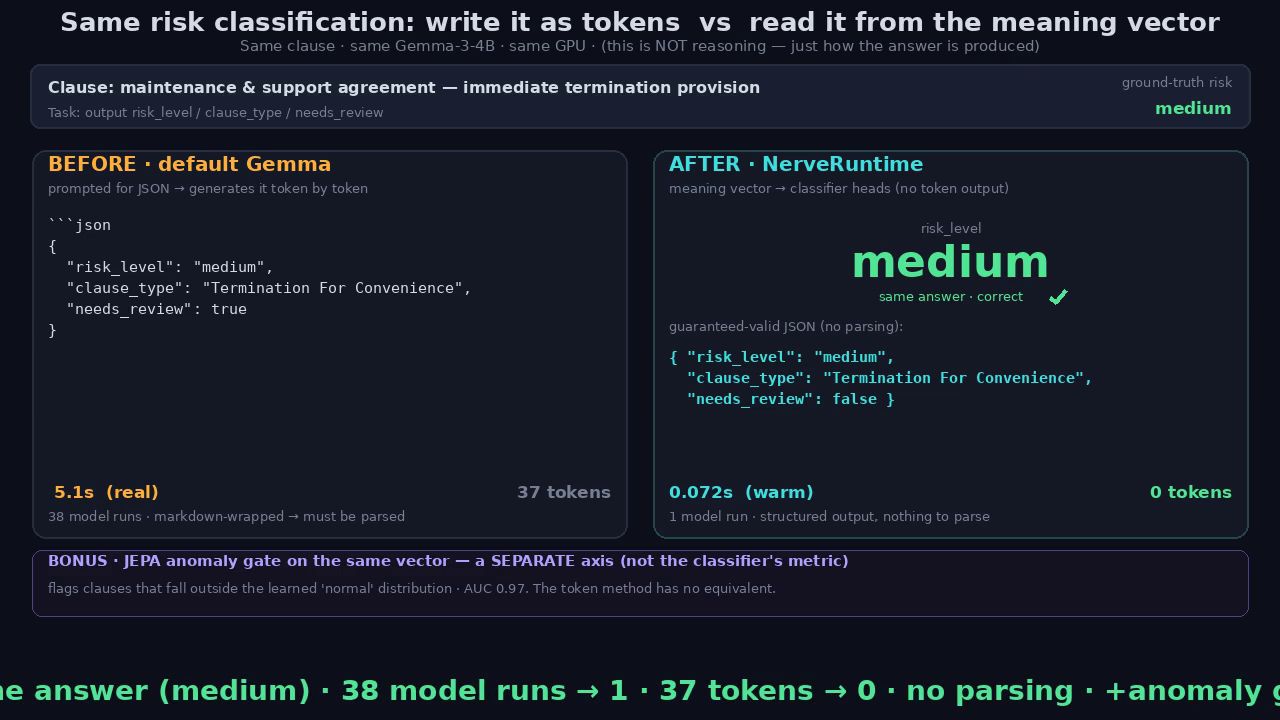
ChatGPT共同開発者のDiogo Almeida氏が発表した、判断に特化したAIモデル「Jev」。発表内容とSNSで拡散されている情報を区別したうえで、速さと安さの仕組みを整理し、NerveReflex の考え方とオープンモデル Gemma 4 26B で同じ方向性の仕組みを再現した検証結果を紹介します。

続きを読む →
AIの暴走はなぜ止まらないのか――OpenAI・Anthropicのインシデントから見える制御の難しさ インサイト
AI SafetyAnthropicOpenAIClaude CodeRecursive Self-ImprovementAI Agents

AIの暴走はなぜ止まらないのか――OpenAI・Anthropicのインシデントから見える制御の難しさ

Claude Code を長時間自律実行させ、複数セッションを連携させた経験から、AIがAIを作る Recursive Self-Improvement 時代の AI Safety を考えます。Anthropic と OpenAI で実際に起きたインシデントを踏まえ、思考の監視や Sandbox だけでは足りない理由と、現実的な多層防御について整理します。

続きを読む →
OpenAIの次世代モデル「Astra」――推論コストを下げながら、より深く考える仕組みとセキュリティ上の懸念 インサイト
AIOpenAILatent ReasoningRecurrent DepthNerveReflexAI SafetyInference Cost

OpenAIの次世代モデル「Astra」――推論コストを下げながら、より深く考える仕組みとセキュリティ上の懸念

OpenAIの次世代モデル Astra に使われていると報じられた Recurrent Depth。言葉を生成せずモデル内部の表現のまま考えるこの方式が、推論コストとAI安全監視に何をもたらすのかを整理し、自作の NerveReflex との違いと組み合わせ方を考えます。

続きを読む →
業務AIエージェントの失敗を防ぐために — FDEとして現場で学んだ「AI 2割・決定論 8割」の設計 インサイト
AIAI AgentsEnterprise AIFDELLM

業務AIエージェントの失敗を防ぐために — FDEとして現場で学んだ「AI 2割・決定論 8割」の設計

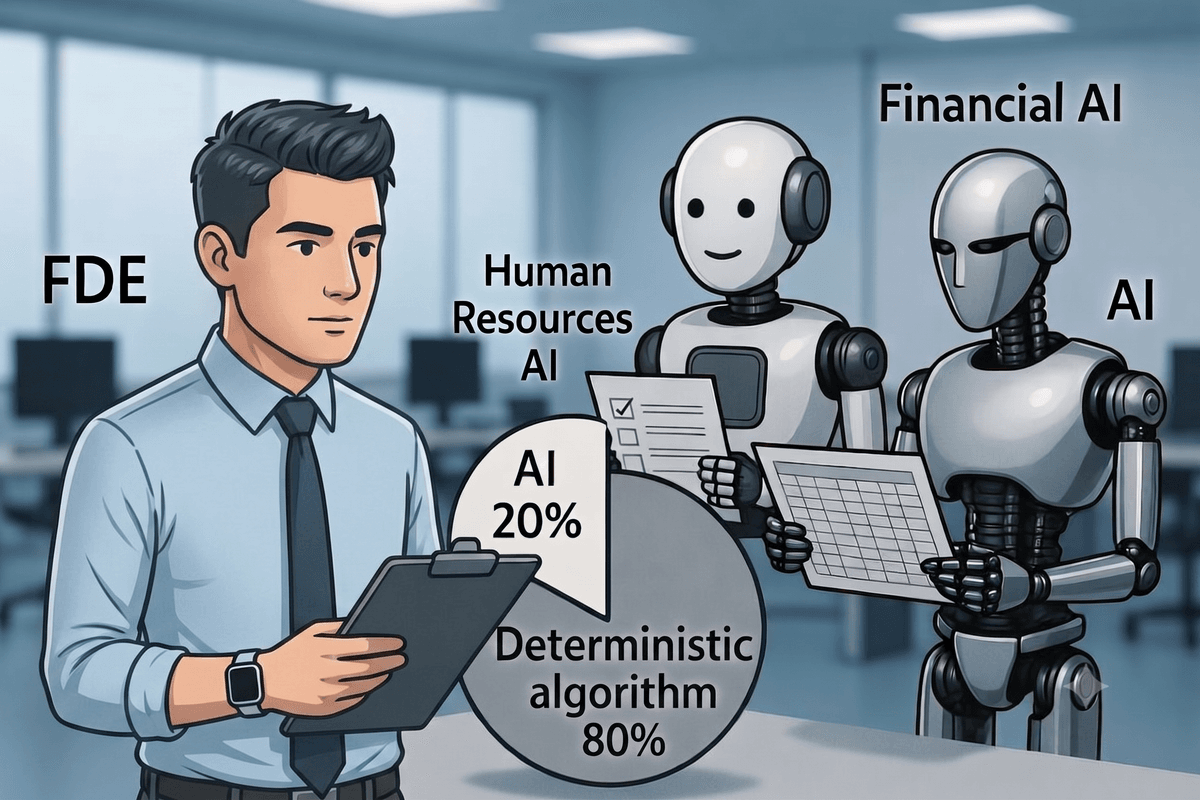
人事・財務の業務AIエージェントを設計から本番運用まで担当した FDE の経験から、「AI 2割・決定論 8割」の設計、汎用アシスタント配布の限界、そして完全自動化ではなく共存の仕組みという3つの結論について書きます。

続きを読む →
第7話. TANREN — 負け戦 Atari Bowling が生んだ「参入ゲート」— 走る前に勝敗を測る秤 連載
TANREN進化的探索FunSearchAtari強化学習LLMPython

第7話. TANREN — 負け戦 Atari Bowling が生んだ「参入ゲート」— 走る前に勝敗を測る秤

R2D2・人間基準・DQN は超えたものの、最強RLの74%で頭打ちになった Atari Bowling の記録です。頭打ちの原因が「読める反応型コード」というクラスの構造的な天井だったことを実測で確定させ、以後のすべての実験の入口を守る「参入ゲート」が生まれるまでを書きます。

続きを読む →
第5話. TANREN — Breakout で「トンネル戦法」を自力発見し、届かない理由も計測で確定させた 連載
TANREN進化的探索FunSearchAtari強化学習LLMPython

第5話. TANREN — Breakout で「トンネル戦法」を自力発見し、届かない理由も計測で確定させた

誰にも教わらず「トンネル戦法」を自力発見し、人間基準の約6.1倍のスコアに到達した Breakout の記録です。同時に、最強の強化学習に届かなかった理由を憶測ではなく計測で確定させ、「読める数十行のコード」という手法の適用範囲に境界線を引きます。

続きを読む →
第2話. TANREN — 20年の古典キャッシュに、本番トレースの「未来」で 11勝1敗 連載
TANREN進化的探索FunSearchキャッシュLLMPythonvLLM

第2話. TANREN — 20年の古典キャッシュに、本番トレースの「未来」で 11勝1敗

キャッシュの追い出し(満杯になったとき何を捨てるか)は、20年以上研究されてきた分野です。その分野で、進化的探索が生成した53行の Python 関数が、Twitter の本番トレースの未来区間で ARC・LIRS・W-TinyLFU を上回りました。一度は特定時期への過適合で負けた経緯、それを解決した「離れた2窓」での訓練、誰でも再現できる公開コードまでを紹介します。

続きを読む →
第8話. TANREN — 「超えた」と言いかけた数字を、自分で取り下げた話 — Atari Freeway と測定の誠実さ 連載
TANREN進化的探索FunSearchAtari強化学習LLMPython

第8話. TANREN — 「超えた」と言いかけた数字を、自分で取り下げた話 — Atari Freeway と測定の誠実さ

一度は「DQN 超え」に見えた 31.9 が、公表側と同じ評価条件で測り直すと 28.6 に下がりました。数字を取り下げ、検証器を修理し、正しい条件で進化をやり直して 31.2 — 人間と DQN を超え、Agent57 の96%に到達するまでの記録です。評価プロトコルの誠実さを主題にした一本です。

続きを読む →
第6話. TANREN — 深層RL最難関の Atari Skiing で、読める Python が公表全RLに全勝した 連載
TANREN進化的探索FunSearchAtari強化学習LLMPython

第6話. TANREN — 深層RL最難関の Atari Skiing で、読める Python が公表全RLに全勝した

Agent57 が人間超えに約780億フレームの学習を要した Atari Skiing で、読める Python 約130行が最終判定 −3310.7 を記録し、公表されている全RLエージェントと人間基準に勝ちました。走る前に勝算を測る「参入ゲート」、進化が自力で加えた工夫、1日・API数ドルというコストの対比を記載します。

続きを読む →